그래픽카드 세대별 로컬 LLM 속도와, 우리 프로덕션이 매일 처리하는 토큰량
모델명·서빙 설정·prefill/decode 실측치까지 전부 공개합니다 (2026-09-26 기준으로 재정리)
지난 글(새 창)에서 그래픽카드를 5090으로 바꾼 얘기를 했습니다. 이 글은 그 뒤를 잇습니다. 실제로 어떤 모델을 어떤 설정으로 돌리는지, 카드별 prefill/decode 속도가 얼마인지, 모델 교체 판정이 어떻게 흘러갔는지를 전부 공개합니다.
이 글은 2026년 8월 27일에 처음 썼고 그 뒤 두 번 덧붙였습니다. 9월 8일에는 5090과 R9700을 함께 묶은 이종 구성 실측을 추가했고, 9월 26일에는 5090 단독 27B dense 튜닝과 R9700 단독 35B MoE 튜닝 결과를 넣으면서 글 전체를 한 흐름으로 다시 정리했습니다. 따로 시점을 적지 않은 문장은 2026년 9월 26일 기준입니다.
처음 쓴 판단 중 나중에 틀린 걸로 드러난 것들은 지우지 않고 그대로 남겼습니다. 대역폭 비율로 속도를 환산한 오판, 콜 단위 평균으로 속도를 잰 실수 같은 것들입니다. 어디서 어떻게 틀렸는지가 숫자 자체보다 더 쓸모 있는 교훈이라고 생각해서입니다.
거쳐온 하드웨어
이 봇의 로컬 LLM 카드는 4070 Ti Super 한 장 → 두 장 → 7900 XTX 한 장 → RTX 5090 한 장 → 5090 + R9700 이종 구성 → 5090 단독(메인) + R9700 단독(백업) 순으로 바뀌어 왔습니다.
| 구성 | VRAM | 모델 | 결과 |
|---|---|---|---|
| 4070 Ti Super ×1 | 16GB | 당시 모델 | 메모리에 아예 안 올라감 |
| 4070 Ti Super ×2 (tensor-split) | 32GB | 35B MoE | 100종목 야간 배치 5.81시간 |
| RX 7900 XTX ×1 | 24GB | 35B MoE | 같은 배치 6.15시간(카드 1장이 2장 대체) |
| RTX 5090 ×1 (8월 27일~9월 5일 프로덕션) | 32GB | 27B dense | 프로덕션 9밤 약 226초/종목(6.3시간) |
RTX 5090 + AMD R9700 ×1 (이종, 레이어 분배 -ts 23,25, 9월 6일~25일 프로덕션) |
32GB+32GB(64GB) | Qwen3.8-Flash-Next | 100종목 369.9초/종목(10.28시간) |
| RTX 5090 ×1 (9월 26일부터 메인) | 32GB | 27B dense, MTP + 슬롯 8 | 재생 실험 102.0초/종목(2.83시간) — 튜닝 글(새 창) |
| AMD R9700 ×1 (백업 경로, 9월 24일 튜닝) | 32GB | 35B MoE, Vulkan 슬롯 4 | 재생 실험 172초/종목(4.79시간) — 튜닝 글(새 창) |
마지막 두 행은 프로덕션이 아니라 얼린 입력을 재생한 실험값입니다. 9월 26일에 메인 모델을 5090의 27B dense(MTP + 슬롯 8)로 전환했지만, 이 설정으로 실제 야간 배치를 완주한 기록은 아직 없습니다.
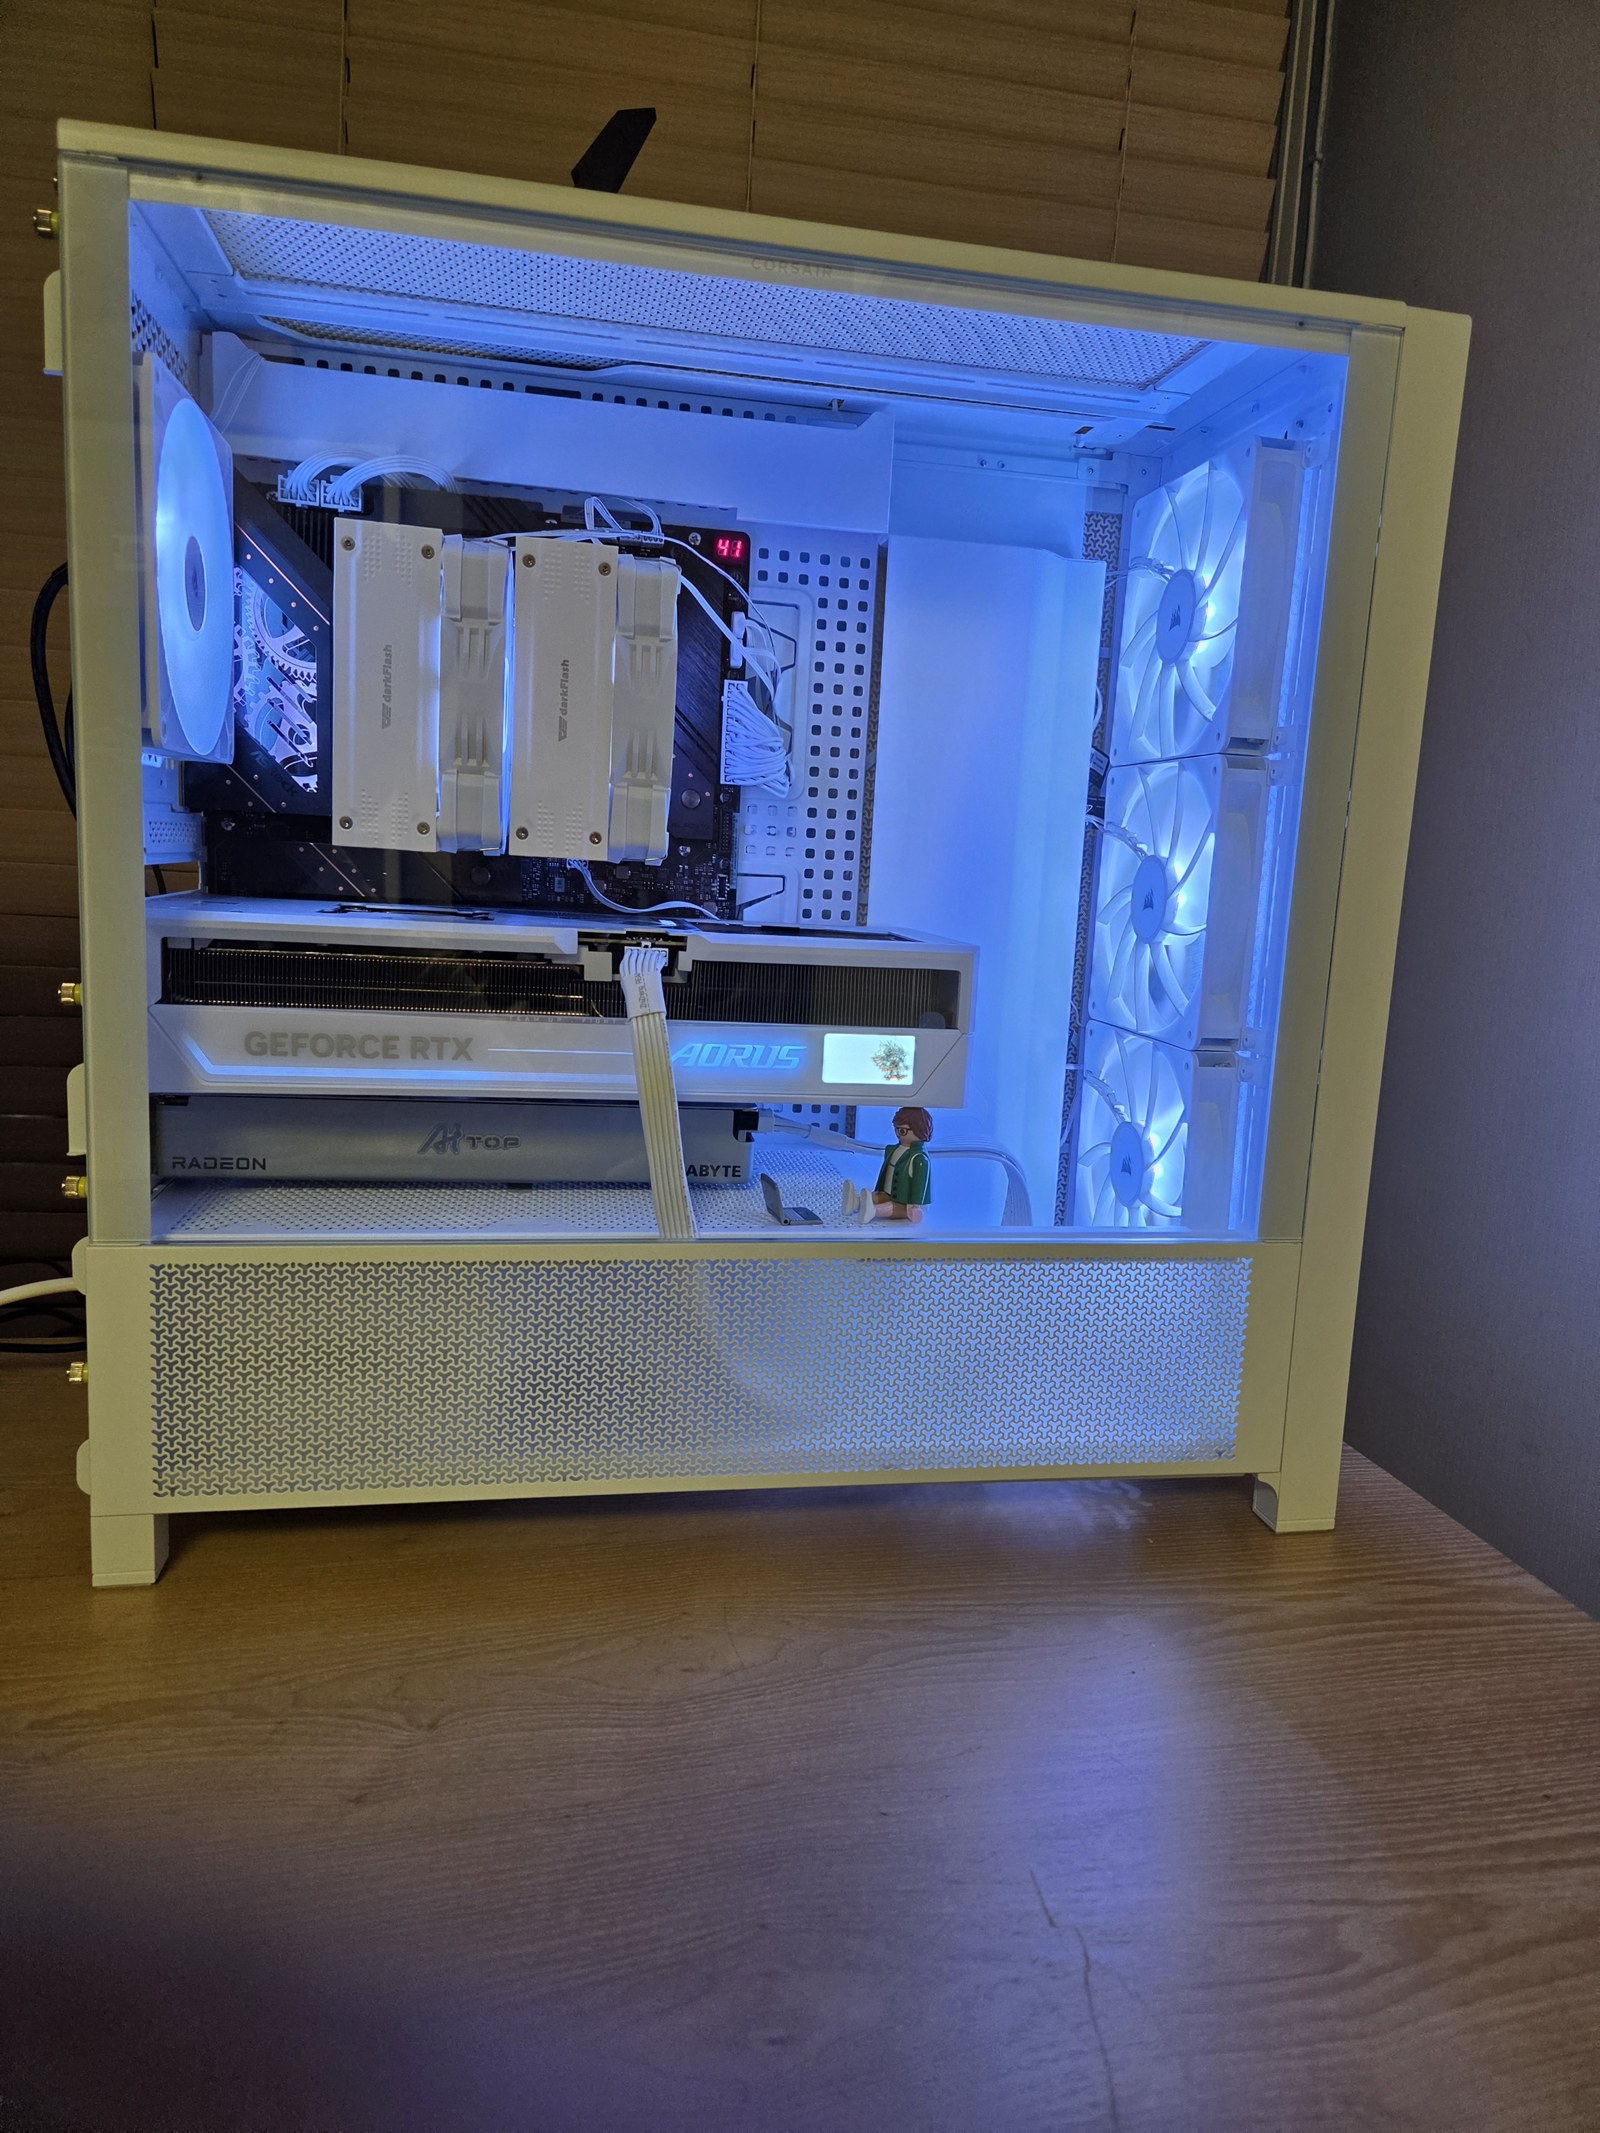
R9700을 실제로 들이게 된 계기와 조립 과정(사진 포함)은 별도 글(새 창)에 정리했습니다 — 사실 메인 카드 후보로 몇 번이나 검토했다가 접었던 카드인데, 목적을 바꿔서 다시 산 사연입니다.
속도를 어떻게 재는가
ta_usage_tracker가 모든 LLM 호출의 input/output 토큰과 소요시간을 종목별로 기록합니다. 처음엔 콜 단위로 output_tokens ÷ elapsed_s를 평균 냈습니다. 그런데 vLLM이 여러 종목 요청을 동시에 배칭 처리(continuous batching)하기 때문에, 그 순간 GPU에 몇 건이 몰려 있었는지에 따라 콜 1건의 체감 속도가 출렁여서 하드웨어 비교로 못 쓸 숫자가 나왔습니다.
그래서 콜 단위 평균 대신 그 배치가 실제로 도는 동안 만든 output 토큰 총량 ÷ 그 배치의 실제 소요시간(첫 콜~마지막 콜) 으로 다시 계산했습니다. 이 글에서 "집계 처리량"이라고 부르는 값이 그것입니다.
같은 이유로 척도가 다른 숫자를 한 칸에 놓지 않으려고 했습니다. 아래 표에는 값마다 척도를 적었습니다. 집계 처리량(동시 요청 전체의 합), 단일 스트림(요청 하나만 돌릴 때), 로그 최댓값(서버 로그에 찍힌 순간 최고치, 평균이 아님)의 셋입니다. 동시성이 올라가면 집계 처리량은 오르지만 스트림당 속도는 내려가므로, 단일 스트림 값과 집계 값을 나눠서 "몇 배"라고 말하면 안 됩니다.
종목당 초도 두 종류가 있습니다. 하나는 처리량 기준(벽시계 시간 ÷ 종목 수)이고, 다른 하나는 슬롯 지연 기준(각 슬롯이 종목 하나를 끝내는 데 걸린 시간)입니다. 후자는 전자의 동시 슬롯 수배라서, R9700 튜닝 중에 188.5초와 504초를 나란히 놓고 "새 빌드가 퇴행했다"고 오해할 뻔했습니다. 이 글의 종목당 초는 전부 처리량 기준입니다.
같은 함정의 반대편도 있습니다. 처리량 기준 종목당 초는 이미 동시성이 반영된 값인데, 여기에 슬롯 수로 한 번 더 나누려던 계산을 리뷰에서 잡았습니다. 이중으로 나누면 속도를 몇 배씩 과대평가합니다.
마지막으로 벽시계 시간은 출력 길이에 교락됩니다. XTX 시절 어떤 런은 출력이 길게 나온 만큼 3시간 넘게 과대 측정됐습니다. 그래서 그 뒤로는 벽시계 하나만 보지 않고 prefill/decode 처리량을 같이 봅니다.
실측 표 — 27B dense, 카드별
같은 27B dense 모델(Qwen3.8-27B), 콜당 prefill 약 12.7k 토큰 기준으로 우리가 직접 돌려본 카드만 정리했습니다. XTX는 llama.cpp, 5090은 vLLM입니다.
| 구성 | decode(척도) | 100종목 환산 | 비고 |
|---|---|---|---|
| RX 7900 XTX, llama.cpp Q4_K_M, MTP on | 62.5 t/s(단일 스트림) | 21.7시간 | prefill 768 t/s. MTP 없이는 30시간 안팎이었음 |
| RTX 5090, vLLM NVFP4, 슬롯 3 — 8월 27일 첫 완주 | 118 t/s(집계 처리량) | 6시간 18분(227초/종목) | 8월 27일 랭킹에 쓴 100종목 완주 1회분 — 아래 맞대결 절 참고 |
| 같은 설정 — 프로덕션 9밤(8월 27일~9월 5일) | — | 약 6.3시간(약 226초/종목) | 9밤 평균 |
| RTX 5090, vLLM NVFP4, 슬롯 3, MTP 끔 — 재생 기준선(9월 23일) | 126 t/s(집계, 스트림당 약 42) | 5.68시간(204.5초/종목) | 얼린 입력으로 100종목 재생 |
| RTX 5090, 슬롯 14 (9월 23일) | 233 t/s(집계, 스트림당 약 27) | 3.22시간(115.8초/종목) | 28종목. 설정은 14인데 실현 동시성은 6~9 — KV 캐시가 한계 |
| RTX 5090, MTP + 슬롯 8 (9월 24일) | 437 t/s(집계, 로그 최댓값) | 2.83시간(102.0초/종목) | 24종목·1회 반복. MTP·슬롯·메모리 사용률을 동시에 바꾼 값이라 MTP 단독 기여는 분리 못 함 |
227초와 226초는 다른 조건의 값입니다. 227초는 8월 27일 첫 완주 1회분(6시간 18분)이고, 226초는 같은 설정으로 9밤 돌린 프로덕션 평균입니다.
XTX의 단일 스트림 값과 5090의 집계 값은 재는 방식이 달라서 직접 나눠서 "몇 배"라고 말하긴 어렵지만, 100종목 환산 시간만 보면 XTX 21.7시간 → 5090 약 6.3시간으로 줄었습니다. 같은 5090에서 튜닝만으로 다시 204.5초 → 115.8초 → 102.0초로 줄어든 과정은 27B 튜닝 글(새 창)에 있습니다. 다만 같은 5090에서 MoE와 직접 맞대결시키면 얘기가 또 달라지는데, 아래에서 다룹니다.
실측 표 — 35B MoE와 Flash-Next
이 표의 모델은 27B dense가 아니라 MoE 계열입니다. 위 표와 직접 비교하면 안 됩니다.
| 구성 | decode(척도) | 100종목 환산 | 비고 |
|---|---|---|---|
| 4070 Ti Super ×2, 35B MoE (33일 평균) | 62.4 t/s(집계 처리량) | 5.81시간 | 정상 야간 전체배치 |
| RX 7900 XTX, 35B MoE (10일 평균) | 71.6 t/s(집계 처리량) | 6.15시간 | 정상 야간 전체배치 |
RTX 5090, 35B MoE, vLLM max-num-seqs 14 (8월 26일) |
911 t/s(집계 처리량) | 46분 | 100종목 첫 완주 1회분 — 아래 맞대결 절 참고 |
| AMD R9700, 35B MoE, llama.cpp Vulkan 슬롯 4 (9월 24일) | 185 t/s(벤치 하니스 4슬롯 합산, 스트림당 약 46) | 4.79시간(172.4초/종목) | 12종목 재생. prefill 약 2,650~3,000 t/s |
| RTX 5090 + AMD R9700 이종, Qwen3.8-Flash-Next Q3_K_XL (9월 7일~8일) | 약 124 t/s(4슬롯 합산, 슬롯당 약 31) | 10.28시간(369.9초/종목) | 100종목 프로덕션 첫 완주. prefill 약 610 t/s |
Flash-Next 행은 카드 두 장을 더했는데 종목당 시간이 오히려 늘어난 경우입니다. 하드웨어 문제가 아니라 모델이 바뀌었기 때문입니다. Flash-Next는 이 글의 27B dense보다는 빠르지만, 35B MoE(active 3B, 46분 완주)보다는 무거운 모델(active 6B)입니다. 이종 GPU 조합에서 양자화 버전을 세 번 갈아치우고 동시 요청 수·배치 크기를 하루 종일 실험한 전체 과정은 별도 글(새 창)에 정리했습니다.
R9700 행은 이종 서빙이 아니라 이 카드 한 장으로 35B MoE를 따로 돌리는 백업 경로입니다. 처음 스윕(9월 4일)에서는 슬롯 3개가 최선이라고 적었다가, 슬롯 4개 완주 데이터를 얻은 뒤 4개로 정정했습니다. 그 과정은 35B MoE 튜닝 글(새 창)에 있습니다.
카드별 순수 decode 속도 — 공개 크로스-GPU 벤치마크
같은 27B dense급 모델, MTP 켠 상태에서 카드별 decode 속도(출처: arca.live 크로스-GPU 스레드(새 창), 컨텍스트 깊이 미통제라 참고용):
| 카드 | decode(t/s) |
|---|---|
| RTX 3090 | 40~45 |
| AMD R9700 | 56 |
| RTX PRO 6000 Max-Q | 70 |
| RX 7900 XTX | 71 |
| RTX 5090 | 80 |
XTX 대비 5090이 약 1.13배 빠릅니다. 8월 27일 처음 이 글을 쓸 때는 대역폭 비율(1.81배)로 환산해서 5090이 훨씬 빠를 거라 기대했는데, MTP가 켜져 있으면 디코드가 대역폭 한계에서 풀려나기 때문에 그 환산이 틀렸다는 게 나중에 드러났습니다.
표의 R9700(56 t/s)은 남이 27B dense급 모델로 잰 참고치입니다. 9월 4일 이 카드를 실제로 사서 직접 재봤을 때는 같은 조건이 아니라 35B MoE 모델·MTP 켬·단일 스트림 기준으로 디코드 130~140 t/s가 나왔고, MTP를 끈 최신 빌드의 단일 스트림은 108 t/s였습니다. 모델이 달라 표와 직접 비교는 안 되지만, 카드 자체가 느린 건 아니라는 근거였습니다.
5090에서 MoE vs dense 직접 맞대결
8월 26일 저녁과 8월 27일 새벽에 같은 5090에서 MoE와 dense를 나란히 돌려서 비교했고, 8월 27일 랭킹에는 dense 결과를 썼습니다. 각 모델이 100종목을 한 바퀴 완주하는 데 실제로 걸린 시간입니다(둘 다 그 모델의 첫 완주 1회분):
| 모델 | 종목 수 | 실행 시각 | 입력 토큰 | 출력 토큰 | 걸린 시간 | 집계 처리량 |
|---|---|---|---|---|---|---|
| MoE(당시 프로덕션) | 100개 | 8월 26일 20:41~21:27 | 18,315,222 | 2,497,437 | 46분 | 911 t/s |
| 27B dense(8월 27일 랭킹에 쓴 후보) | 100개 | 8월 27일 00:13~06:31 | 18,982,363 | 2,680,713 | 6시간 18분 | 118 t/s |
같은 5090, 같은 100종목인데 MoE가 dense보다 약 7.7배 빠릅니다. dense가 느린 건 하드웨어 문제가 아니라 모델 구조(MoE는 활성 파라미터만 계산, dense는 전체 파라미터를 매번 계산) 자체의 특성입니다.
서빙 설정과 MTP
서빙 구성은 시대별로 이렇게 바뀌었습니다.
8월 27일 시점. 밤마다 돌던 모델은 Qwen3.6-35B-A3B(MoE, active 3B), GGUF Q4_K_M 양자화였습니다. 가중치 20.75GiB + KV/연산 버퍼 1.16GiB = 실사용 21.91GiB(XTX 24GB의 91%)입니다. vLLM 서버는 포트 8200, max-num-seqs 14, KV 캐시 fp8, prefix caching 끔, temperature 0.8, thinking 모드 끔으로 동결해서 썼습니다. 동시에 Qwen3.8-27B(dense) 를 같은 조건(KV fp8, prefix caching 끔, temp 0.8, thinking 끔)에 max-num-seqs만 3으로 낮춰서 판정 중이었습니다 — dense는 MoE와 메모리/연산 특성이 달라서 동시 처리 개수를 줄여야 안정적이었습니다.
8월 28일~9월 5일. 27B dense를 채택해 5090 한 장에서 vLLM으로 9밤 돌렸습니다. 양자화는 NVFP4 체크포인트, KV 캐시 fp8, 동시 슬롯 3개였습니다.
9월 6일~25일. 서빙 스택을 llama.cpp로 바꾸고, 5090과 R9700을 하나의 llama.cpp 서버에 묶어(-sm layer -ts 23,25 -np 4 -b 512 -c 131072) Qwen3.8-Flash-Next(Q3_K_XL) 를 돌렸습니다.
9월 26일 현재. 메인은 5090 한 장에서 vLLM으로 돌리는 27B dense(NVFP4, KV fp8, max-num-seqs 8, MTP 투기 토큰 2개, GPU 메모리 0.95)입니다. 백업 경로는 R9700에서 llama.cpp Vulkan으로 돌리는 35B MoE(Q4_K_M, 동시 슬롯 4, MTP 끔)입니다. 서빙 스택은 vLLM으로 돌아왔습니다.
MTP(speculative decoding)는 8월 27일 시점 글에 "상시 켜져 있다"고 적었습니다. 지금은 그렇지 않습니다. 5090 vLLM의 27B dense는 프로덕션 9밤과 재생 기준선 모두 MTP를 끈 설정이었고, 이 조합에서 MTP를 켠 건 9월 24일 재생 실험이 처음입니다. R9700 백업 경로는 아래 이유로 MTP를 끕니다.
MTP 수용률은 모델·설정에 따라 편차가 큽니다. 8월 27일 시점에 알던 값은 우리 35B MoE 기준 50.1%, 외부에서 잰 27B dense 66.95%, 다른 외부 실측 81~97%였습니다. 이후 직접 재본 값으로, vLLM에서 5090의 27B dense는 투기 토큰 2개로 수용률이 창별 65~79%였습니다. 반면 R9700의 35B MoE는 백엔드와 동시성에 상관없이 약 50%였고, 동시 슬롯이 2개 이상이면 MTP가 오히려 손해였습니다(슬롯 3개에서 1.58배 느려짐). 그래서 R9700 백업 경로는 MTP를 끄고 슬롯 4개로 돌립니다.
모델 채택 판정 경과
8월 27일 시점에는 dense와 MoE 중 어느 쪽을 정식으로 쓸지 결론이 나지 않았습니다. 그날 비교를 위해 실제 랭킹을 dense로 만들어봤지만 그게 "정식 채택"을 뜻하진 않았습니다. 진행 중이던 검증 방법 하나는 self-QWK: 같은 종목셋을 여러 번 반복 실행해서 등급이 얼마나 일관되게 나오는지 재는 지표(quadratic weighted kappa)입니다. MoE는 같은 99종목으로 3번 반복한 결과가 있었습니다(위 맞대결의 MoE 실행도 이 반복 중 하나입니다):
| 비교쌍 | QWK | raw 일치 |
|---|---|---|
| rep1 vs rep2 | 0.0853 | 59/99 |
| rep1 vs rep3 | 0.1260 | 56/99 |
| rep2 vs rep3 | 0.1481 | 61/99 |
| 평균 | 0.1198 |
과거 XTX 시절 관측된 self-QWK 밴드는 0.08~0.21이라, 이 값(0.1198)은 그 안에 들어옵니다. 등급 분포를 까보면 Hold가 71~80%로 쏠려 있는데, QWK는 한 등급에 쏠릴수록 수치가 기계적으로 낮게 나오는 특성이 있어서 raw 일치율(56~61%)도 같이 봐야 합니다.
dense 쪽 self-QWK는 8월 27일 시점엔 측정 전이었고(그 주말에 재기로 했었음), 이 글에는 그 결과를 싣지 않았습니다. 실제 채택을 가르는 진짜 게이트는 self-QWK가 아니라 forward RankIC(예측 순위와 실제 수익률 순위의 상관)인데, 이 지표는 지금도 측정치가 0건입니다. 즉 "dense가 더 잘 나올 것 같다"는 정성적 기대만 있고, 실제로 그런지는 검증 전입니다.
경과는 이렇습니다. 27B dense가 8월 28일에 채택됐고, 9월 6일에 Flash-Next로, 9월 26일에 다시 속도를 튜닝한 27B dense(MTP + 슬롯 8)로 전환했습니다. 이 조합의 forward RankIC는 여전히 0건입니다.
매일 처리하는 토큰량
이 프로젝트에는 로컬 LLM으로 종목을 분석하는 AI 파이프라인(새 창)이 있습니다.
평소(모델 비교 없이 MoE 단독 운영) 평일 평균: 호출 약 5,200회, 입력 토큰 약 5,500만 개, 출력 토큰 약 750만 개.
위 맞대결과 같은 100종목 완주 1회분 기준:
| 모델 | 커버 종목 | 종목당 호출 | 입력 토큰 | 출력 토큰 |
|---|---|---|---|---|
| MoE(당시 프로덕션) | 100개 | 17회 | 18,315,222 | 2,497,437 |
| 27B dense(8월 27일 랭킹에 쓴 후보) | 100개 | 17회 | 18,982,363 | 2,680,713 |
이 구간은 두 모델 다 종목당 호출 수가 같아서(17회) 토큰량 자체는 거의 비슷합니다 — 차이는 토큰량이 아니라 위에서 본 "걸린 시간"(46분 vs 6시간 18분)에서 납니다. 참고로 정상적으로 하루 종일 도는 MoE 단독 운영일(평일 평균)에는 종목당 호출 수가 이보다 훨씬 많은 약 55~71회까지 올라가는 날도 있어서, 호출 깊이 자체는 그날그날의 실행 목적(정식 배치인지, 이런 비교 실행인지)에 따라 달라집니다.
다음, 그리고 아직 확인 못 한 것
5090의 27B dense(MTP + 슬롯 8)로 도는 첫 프로덕션 밤은 9월 29일 예정입니다. 그때 실제 100종목 시간을 재서 재생 실험의 2.83시간과 얼마나 다른지 확인합니다.
9월 28일부터는 R9700 백업 경로가 메인 경로와 같은 100종목을 매일 밤 나란히 채점해서 두 경로의 forward RankIC를 쌓기 시작합니다. 지금까지 forward RankIC 측정치는 어느 조합에도 0건이고, 속도가 빠르다는 것과 신호가 믿을 만하다는 것은 별개의 문제입니다. 판정 결과가 나오면 별도 글로 정리하겠습니다.